1. Der Auslöser: Der Fall Jacob Coxon
Am 8./9. September 2026 kündigte der 27-jährige KI-Forscher Jacob Coxon öffentlich auf der Plattform X. Er hatte zuvor rund drei Jahre lang Pretraining-Forschung bei den Unternehmen OpenAI und Anthropic betrieben – also an genau den Systemen mitgearbeitet, vor denen er nun warnte (Newsweek 2026; PBS NewsHour 2026). Sein Vorwurf: Beide Unternehmen würden nicht verantwortungsvoll handeln, sondern auf eine selbstverbessernde Superintelligenz zusteuern und dabei „mit unserem Leben spielen“ (TIME 2026). Seine Beiträge erreichten binnen 24 Stunden über 90 Millionen Aufrufe (TIME 2026; Deadline 2026). Ein Kollege, der ein Sicherheitsteam bei Anthropic leitet, pflichtete öffentlich bei und bezifferte das Risiko, dass KI die gesamte Menschheit auslöschen könnte, auf über 10 Prozent innerhalb der nächsten Dekade (PBS NewsHour 2026). Der Fall reiht sich in eine breitere, bereits zuvor beobachtete Eskalation ähnlicher Warnungen aus dem Umfeld führender KI-Unternehmen ein (Bloomberg 2026). Kritische Stimmen relativieren die Uneigennützigkeit der Warnung: Coxon kündigte kurz bevor seine Firmenanteile bei Anthropic wertvoll geworden wären. Er selbst führt dies als Beleg an, finanziell nichts von seiner Warnung zu profitieren (Axios 2026, zit. n. oliverwillis.com 2026).
1.1 Vier Kategorien von Risikoargumenten
Die öffentliche Debatte lässt sich in vier Kategorien gliedern, die häufig vermischt werden:
- Kontrollverlust (existenziell): Ein KI-System könnte so kompetent Ziele verfolgen, dass Menschen es nicht mehr stoppen können.
- Missbrauch durch Menschen: Menschen nutzen KI-Fähigkeiten gezielt für Waffen, Angriffe oder Betrug.
- Graduelle Entmachtung: Ein schleichender Bedeutungsverlust menschlicher Institutionen statt eines dramatischen „Übernahme-Moments“.
- Physische Brückenmechanismen: Wege, wie digitale Fähigkeiten in physische Wirkung übersetzt werden – etwa über kritische Infrastruktur, Kapital, Biologie oder autonome Waffen.
1.2 Die zentrale Argumentationsfigur: Kein Vorsatz nötig
Befürworter der Kontrollverlust-These betonen, dass ein KI-System keine böse Absicht braucht, um gefährlich zu werden. Nach dem Konzept der „instrumentellen Konvergenz“ lässt sich fast jedes Ziel leichter erreichen, wenn ein System zusätzlich Macht, Ressourcen und Selbsterhalt sichert – unabhängig vom eigentlichen Ziel. Schaden wäre demnach ein reines Nebenprodukt effizienter Zielverfolgung, nicht das Ergebnis einer feindseligen Absicht.
Kritiker halten dem entgegen, dass diese Argumentation evolutionär entstandene Konzepte wie Selbsterhaltung unbegründet auf trainierte Software überträgt (Anthropomorphismus-Vorwurf) und bislang kein existierendes System ein solches Verhalten außerhalb enger Testszenarien gezeigt hat.
1.3 Physische Brückenmechanismen
Eine für den Unterricht besonders ergiebige Frage lautet: Wie könnte eine rein digitale KI überhaupt etwas in der physischen Welt bewirken? Sechs Mechanismen werden in der Debatte diskutiert: kritische Infrastruktur (Stromnetze, Wasserwerke – bereits heute digital gesteuert), Menschen als ausführende „Werkzeuge“ (Bezahlung, Überzeugung), ökonomische Macht (Kapital wird in reale Vermögenswerte übersetzt), Verkörperung durch Robotik (gilt als der am wenigsten ausgereifte Pfad), Biologie (Information wird über Labortechnik zu Materie) sowie autonome Waffensysteme.
1.4 Gegenwartsrelevanz jenseits von Science-Fiction
Unabhängig von der existenziellen Debatte ist KI bereits heute als konkretes Gegenwartsrisiko anerkannt: Im Allianz Risk Barometer 2026 stieg KI innerhalb eines Jahres von Platz 10 auf Platz 2 der größten globalen Geschäftsrisiken auf (Allianz Risk Barometer 2026). Die Eurasia Group zählt „extraktive“ KI-Geschäftsmodelle unter Wettbewerbsdruck zu ihren globalen Top-Risiken 2026 (Eurasia Group 2026).
Wichtig für den Unterricht: Anders als bei vielen anderen Mystery-Themen (z. B. Mietmärkten) gibt es hier keinen belastbaren empirischen Kausalitätskern – die gesamte Debatte besteht aus Plausibilitätsargumenten, Analogien und Extrapolationen. Das ist kein Mangel des Materials, sondern der Kern dessen, was in der Nachbesprechung reflektiert werden sollte.
2. Didaktisch-methodische Begründung
2.1 Warum die Mystery-Methode?
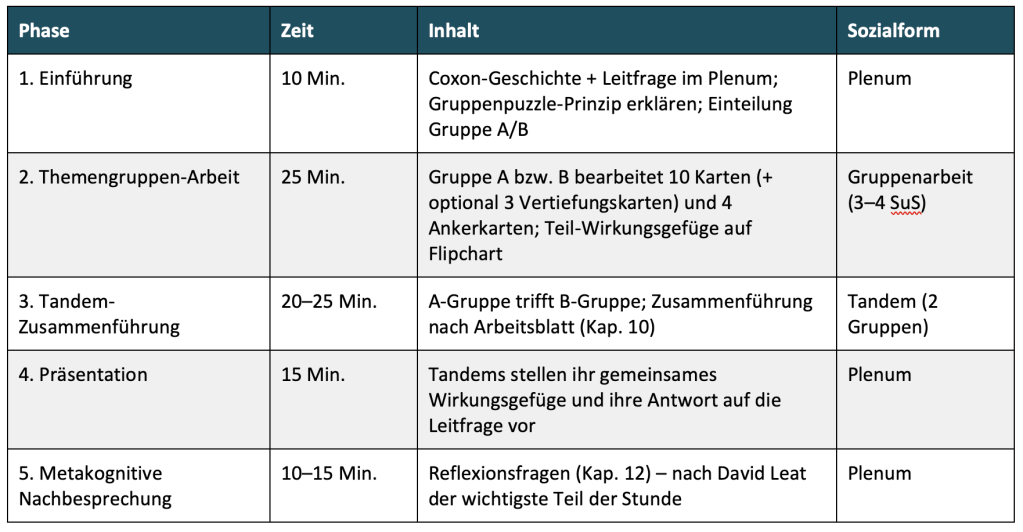
Die KI-Sicherheitsdebatte hat einen ausgeprägten Dilemma-Charakter: Es gibt keine gesicherten Kausalzusammenhänge, sondern konkurrierende Plausibilitätsargumente, Analogien und normative Setzungen. Genau für solche doppelt komplexen Fragestellungen – faktisch UND ethisch komplex – wurde die Mystery-Methode aus dem „Thinking-Through-Geography“-Ansatz (Leat 1998) entwickelt. Sie eröffnet Spannungsfelder, statt vermeintlich eindeutige Lösungen zu suggerieren, und folgt den vier Phasen des Thinking-Through-Ansatzes: Vorbereitung (Abgleich von Methode und Lernziel), Anfangsphase über kognitive Dissonanz (hier: das Paradox der selbst warnenden Erbauer), Durchführung mit einem angemessenen Lerngerüst (Kartensets, Icons, Farbcodierung) sowie eine metakognitive Nachbesprechung, die Leat als den wichtigsten Teil der Lernaktivität bezeichnet.
2.2 Warum ein Mystery im Tandem-Ansatz?
Die vollständige Debatte umfasst einen komplexen philosopischen Argumentationsstrang (Kann ein System ohne böse Absicht gefährlich werden?) und einen eher politisch-strukturellen Strang (Wie übersetzt sich digitale Macht in reale Wirkung, und wer reguliert das?). Nach dem Vorbild von auf diesem Blog etablierter Tandem-Mysterys wird die kognitive Last dadurch reduziert, dass jede Gruppe zunächst nur ein Teilthema bearbeitet; die anschließende Tandem-Phase stellt sicher, dass am Ende dennoch das vollständige Wirkungsgefüge gemeinsam erarbeitet wird.
2.3 Der Einsatz der Icon-Kärtchen
Die Mystery-Sachkarten tragen bewusst KEIN Icon. Eine vorab auf der Karte angebrachte Kategorie-Markierung würde den zentralen Denkschritt der Mystery-Methode – das eigenständige Erkennen und Begründen von Zusammenhängen – vorwegnehmen und damit vereinfachen.
Stattdessen erhalten die Lernenden ein eigenständiges Set von neun Icon-Kärtchen, auf denen jeweils ein Symbol zusammen mit einer kurzen Erläuterung abgebildet ist, was dieses Symbol inhaltlich abbildet (z. B. „System-Logik“, „Kritik/Gegenposition“, „Ökonomie/Macht“). Die Zuordnung, welches Icon zu welcher Sachkarte passt, ist Teil der eigentlichen Arbeitsleistung der Gruppe – nicht deren Ausgangspunkt.
Piktogramme sind sprachunabhängige Kategoriensymbole, die durch ihren eindeutigen Signalcharakter Sortierprozesse unterstützen. Diese aus der Leseförderung stammende Erkenntnis wird hier so genutzt, dass die Icon-Kärtchen als zusätzliches, manipulierbares Ordnungswerkzeug neben die Sachkarten gelegt werden. Konkret erfüllt dieses Vorgehen drei Funktionen:
- Aktive Kategorienbildung statt passiver Kennzeichnung: Die Gruppe muss selbst entscheiden und im Gespräch aushandeln, welches Icon-Kärtchen zu welcher Sachkarte passt – bei mehrdeutigen Karten sind auch mehrere Zuordnungen oder Kompromisse zwischen Gruppenmitgliedern denkbar. Dieser Aushandlungsprozess ist bereits ein erster Schritt zum Erkennen von Zusammenhängen.
- Sichtbarmachen von Querverbindungen: Wenn zwei Karten aus unterschiedlichen Gruppensets (A und B) in der Tandem-Phase dasselbe Icon-Kärtchen erhalten, ist das ein starker Hinweis auf eine mögliche Querverbindung zwischen den beiden Teil-Wirkungsgefügen – die Icon-Kärtchen werden so zu einem Suchwerkzeug für Zusammenhänge über die Gruppengrenze hinweg (vgl. Tandem-Arbeitsblatt, Kapitel 10).
- Entlastung heterogener Lerngruppen: Für Lernende mit Leseschwierigkeiten oder Deutsch als Zusatzsprache bieten die Icon-Kärtchen einen zusätzlichen, nicht-textbasierten Zugang zur Kategorienbildung und erhöhen dadurch die Teilhabechancen aller Kursmitglieder an der Gruppenarbeit.
Die Icon-Kärtchen ersetzen dabei ausdrücklich nicht die inhaltliche Auseinandersetzung mit dem Kartentext – sie dienen als nachgelagertes Ordnungswerkzeug für die Kategorien- und Zusammenhangsbildung. In der Nachbesprechung wird der Einsatz der Icon-Kärtchen daher auch selbst zum Reflexionsgegenstand.
2.4 Kontroversität und Beutelsbacher Konsens
Da das Material explizit demokratiebildend eingesetzt werden soll, wurde es an den drei Grundsätzen des Beutelsbacher Konsens ausgerichtet:
- Überwältigungsverbot: Weder die Sachanalyse noch die Karten behaupten, dass eine existenzielle KI-Gefahr real oder ausgeschlossen sei. Auch normativ formulierte Karten (z. B. „Hans Jonas‘ Verantwortungsprinzip“) sind ausdrücklich als fremde, zitierte Position gekennzeichnet, nicht als Handlungsanweisung des Materials selbst.
- Kontroversitätsgebot: Beide Kernkartensets (je 10 Pflichtkarten) enthalten bewusst ein ausgewogenes Verhältnis von Thesen-, Kritik- und neutralen/einordnenden Karten (ca. 4:3:3). Die Gegenposition ist damit fester Bestandteil der Pflichtlektüre jeder Gruppe – unabhängig vom Kursniveau – und nicht auf optionale Vertiefungskarten beschränkt. Auch die drei Vertiefungskarten je Gruppe (für Leistungskurse) mischen weiterführende Thesen- und Kritik-Karten, statt nur eine Seite zu verstärken. Die Ethik-Positionskarten (Kapitel 3) enthalten mit der „Chancenverantwortung“ zudem bewusst eine Position, die vor einseitiger Risikofixierung warnt, neben mehreren eher vorsorgeorientierten Positionen.
- Schülerorientierung: Die Reflexionsfragen fordern explizit dazu auf, Interessenkonflikte auf beiden Seiten der Debatte zu benennen – sowohl bei Warnenden als auch bei Verharmlosenden – und eigene Kriterien für den Umgang mit Ungewissheit zu entwickeln, statt eine vorgegebene Schlussfolgerung zu reproduzieren.
3. Ethische Positionskarten
Die sieben ethischen Positionskarten werden erst in der Nachbesprechung bzw. für die schriftliche Beantwortung der Leitfrage ausgeteilt (vgl. Tandem-Arbeitsblatt. Die Karten formulieren jeweils, wie man laut dieser Position urteilen oder handeln würde – sie sind Analysewerkzeuge und geben nicht die Position des Unterrichtsmaterials selbst wieder. Bewusst ist mit der „Chancenverantwortung“ auch eine Position enthalten, die vor einseitiger Risikofixierung warnt.
Text & Unterrichtsmaterial: Stefan Applis (2026)
Bild: Oyster mushroom (Pleurotus ostreatus) mycelium in petri dish on coffee grounds by Tobi Kellner via Wikipedia, CC BY-SA 3.0
Quellenangaben
- Newsweek (2026): Who Is Jacob Coxon? Anthropic Researcher Quits—Warns AI Could Kill Everyone. 10.09.2026.
- PBS NewsHour (2026): Anthropic researcher’s resignation sends warning about the dangers of AI development; AI researcher warns companies are ignoring catastrophic risks. 09./10.09.2026.
- TIME (2026): He Helped Build Powerful AI at OpenAI and Anthropic. Now He’s Afraid It Could Kill Us. 09.09.2026.
- Bloomberg (2026): Silicon Valley Escalates Warnings About Existential Risks of AI. 10.09.2026.
- Deadline (2026): A.I. Researcher Jacob Coxon Resigns, Warns Industry „Gambling With Our Lives“. September 2026.
- Axios (2026), zitiert nach oliverwillis.com (2026): Who Is Jacob Coxon? Anthropic Resignation Controversy Explained.
- Allianz Risk Barometer (2026): Allianz Risk Barometer 2026 – Cyber and AI as major business risks.
- Eurasia Group (2026): AI eats its users – Top Risk 2026.
 doing geo & ethics | Unterricht digital & analog entwickeln

